Linear Algebra Basic
Linear Algebra Basic
[Linear Algebra] Basic Concepts & Matrix DecompositionDate: 2026-02-05 Topic: Linear Algebra for Data Science Reference: Yonsei Data Science Lab (DSL) Lecture Notes **
1. Linear Algebra Basic
1.1 Vector & Norm 벡터(Vector)는 크기(Magnitude)와 방향(Direction)을 가지는 양이다. 데이터 사이언스에서 벡터의 ‘크기’를 측정하는 척도로 Norm을 사용한다.
Definition of Norm 함수 $|\cdot|: \mathbb{R}^n \rightarrow \mathbb{R}$ 이 다음 세 가지 성질을 만족하면 Norm이라고 한다.
- Definiteness: $|x| = 0 \iff x = 0$
Homogeneity: $|cx| = c |x|$ - Triangle Inequality: $|x+y| \le |x| + |y|$
Common Norms • L1 Norm (Manhattan): $|x|1 = \sum{i=1}^n |x_i|$ ◦ Usage: Lasso 회귀, 희소성(Sparsity) 유도.
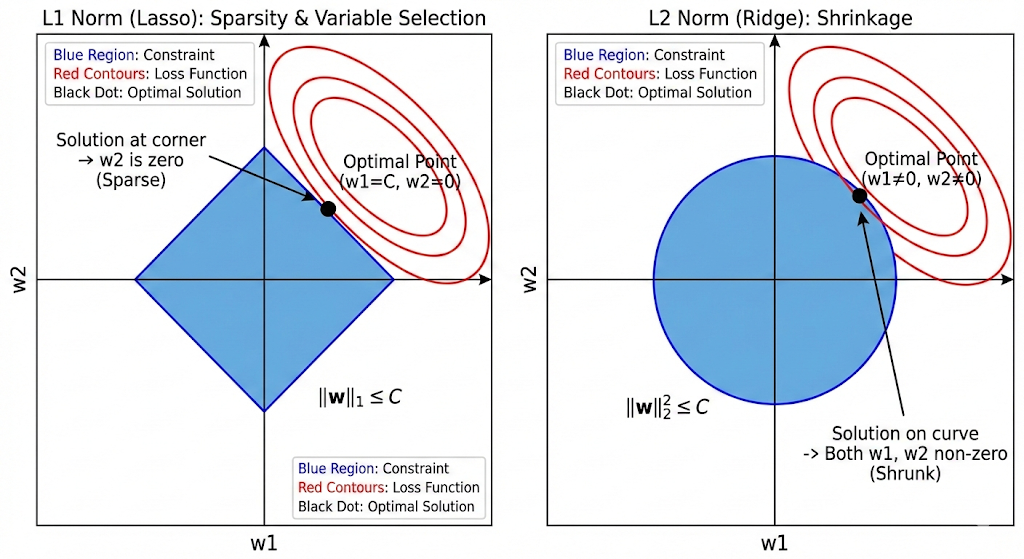
◦ 제약 조건의 모양: L1 규제항의 제약 범위 $|w|_1 \leq C$는 다이아몬드(정사각형을 회전시킨 모양) 형태를 띱니다. 반면 L2(Ridge)는 원형입니다.
◦ 최적점의 위치: 오차를 최소화하는 타원형의 손실 함수 그래프가 제약 범위와 만날 때, L1의 다이아몬드 모양은 모서리(Axis-aligned corner)에서 만날 확률이 압도적으로 높습니다.
◦ 결과: 모서리에서 만난다는 것은 특정 축의 값이 0이 된다는 것을 의미하며, 이는 곧 해당 변수가 모델에서 제거됨을 뜻합니다.
• L2 Norm (Euclidean): $|x|2 = \sqrt{\sum{i=1}^n x_i^2}$ ◦ Usage: 가장 일반적인 거리 척도, Ridge 회귀. 코시-슈바르츠 부등식$(x^Ty \le |x||y|)$의 기반.
- 접점의 위치: 오차를 나타내는 타원형 그래프가 제약 조건과 만나는 최적점($\hat{w}$)을 찾을 때, 원형인 L2는 축(Axis) 위가 아닌 곡선 상의 어느 지점에서 만날 확률이 훨씬 높습니다.
- 결과: 특정 계수가 정확히 0이 되지 않고, $w_1, w_2$ 모두 작은 값을 유지하며 살아남게 됩니다.
| • Max Norm: $|x|\infty = \max{1\le i \le n} | x_i | $ |
- 가중치 상한선 제어, 적대적 노이즈 제한.
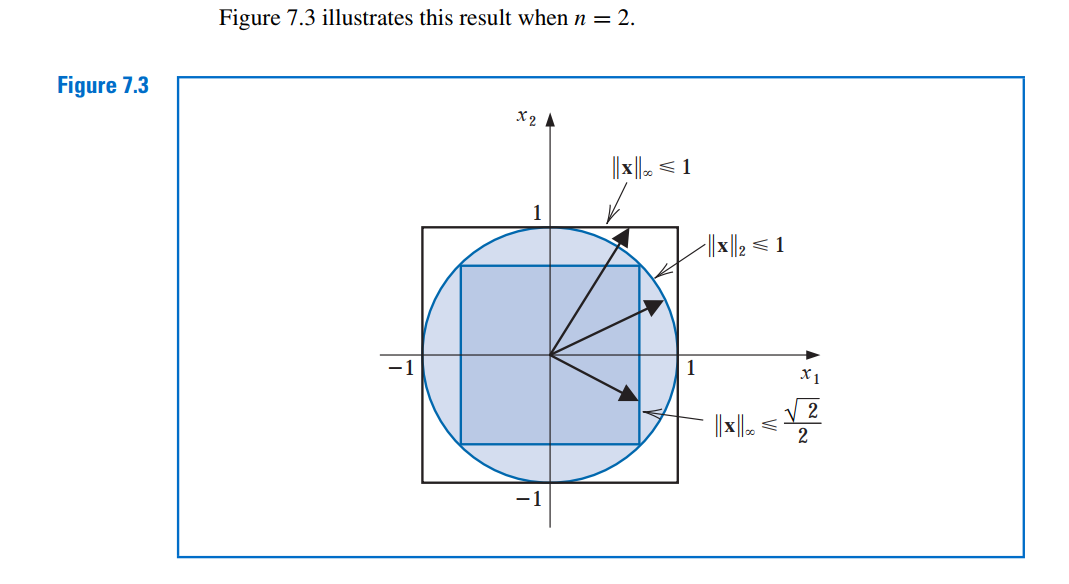
L1 Norm (Manhattan): 다이아몬드 형태 ◦ $|x| + |y| \le 1$을 만족하는 영역입니다. ◦ 축(Axis)에 해당하는 꼭짓점이 뾰족하게 튀어나와 있어, 최적화 과정에서 이 꼭짓점(특정 변수가 0인 지점)과 만날 확률이 높습니다. 이것이 희소성(Sparsity)이 발생하는 기하학적 이유입니다.
L2 Norm (Euclidean): 원 형태 ◦ $\sqrt{x^2 + y^2} \le 1$을 만족하는 영역입니다. ◦ 모든 방향으로 거리가 균일하게 측정되는 우리가 아는 일반적인 ‘원’입니다. 어느 한 축으로 치우치지 않고 가중치를 부드럽게 수축시킵니다.
Max Norm ($L_\infty$): 정사각형 형태 ◦ $\max(|x|, |y|) \le 1$을 만족하는 영역입니다. ◦ 즉, $x$와 $y$ 모두 각각 $[-1, 1]$ 범위 안에만 있으면 됩니다. ◦ 가장 큰 원소의 크기만 제한하므로, 개별 성분이 가질 수 있는 허용 범위가 가장 넓습니다. **
1.2 Matrix Calculus (Important for ML) 머신러닝의 최적화 과정(Gradient Descent)에서 필수적인 행렬 미분 공식이다.
Gradient Vector 스칼라 함수 $f : \mathbb{R}^n \rightarrow \mathbb{R}$ 를 벡터 $x$ 로 미분하면 그 결과는 벡터가 된다.
$\nabla f(x) = \frac{\partial f}{\partial x} = \begin{bmatrix} \frac{\partial f}{\partial x_1} \ \vdots \ \frac{\partial f}{\partial x_n} \end{bmatrix}$
Key Formulas (암기 필수)
Linear Form:$f(x) = w^T x \implies \nabla f(x) = w$
Quadratic Form: $f(x) = x^T A x \implies \nabla f(x) = (A + A^T)x$
- 만약 $A$가 대칭행렬(Symmetric Matrix)이라면, $A=A^T$ 이므로 $\nabla f(x) = 2Ax$ 가 된다. (스칼라 미분 $ax^2 \to 2ax$ 와 유사)
[Note] Jacobian Matrix 벡터 함수 $f: \mathbb{R}^n \to \mathbb{R}^m$ (입력도 벡터, 출력도 벡터)를 미분하면 행렬 형태인 Jacobian이 나온다.
$J = \frac{\partial f}{\partial x} \in \mathbb{R}^{m \times n}$ **
1.3 Linear Independence & Rank Linear Independence (선형 독립) 벡터들의 선형 결합(Linear Combination)이 0이 되기 위한 계수 조건이 모두 0인 경우를 말한다.
$c_1v_1 + \dots + c_mv_m = 0 \iff c_1 = \dots = c_m = 0$ • 의의: 회귀분석에서 다중공선성(Multicollinearity)이 없음을 의미한다. 즉, 변수들이 서로 다른 정보를 담고 있어 모델이 안정적이다.
Rank (랭크) 행렬의 행(Row) 또는 열(Column) 벡터들 중 선형 독립인 벡터의 최대 개수. • Full Rank: $A \in \mathbb{R}^{n \times n}$ 일 때, $\text{rank}(A) = n$. ◦ $\iff A$는 역행렬이 존재한다 (Invertible). ◦ $\iff \det(A) \neq 0$ ◦ $\iff Ax=0$ 의 해는 $x=0$ 뿐이다. **
1.4 Definiteness (정부호) 이차형식(Quadratic Form) $f(x) = x^T A x$ 의 부호에 따른 행렬 $A$의 성질이다. (단, $A$는 대칭행렬).
| 분류 | 정의 ($\forall x \neq 0$) | 고유값 조건 (λi) | 기하학적 의미 |
|---|---|---|---|
| Positive Definite (PD) | $x^T A x > 0$ | 모든 $\lambda_i > 0$ | 아래로 볼록 (Convex) |
| Positive Semidefinite (PSD) | $x^T A x \ge 0$ | 모든 $\lambda_i \ge 0$ | 평평하거나 아래로 볼록 |
| Negative Definite (ND) | $x^T A x < 0$ | 모든 $\lambda_i < 0$ | 위로 볼록 (Concave) |
[Connection] Convex Optimization 함수 $f(x)$의 이계도함수 행렬인 Hessian Matrix가 PD(Positive Definite)이면, 해당 함수는 Convex(볼록) 함수이며, Local Minimum이 곧 Global Minimum이 된다.
Local Minimum = Global Minimum의 원리
볼록 함수에서 임의의 국소적 최솟값이 곧 전체 최솟값이 되는 이유는 “할선(Secant Line)이 함수 그래프보다 위나 같게 위치한다”는 볼록성의 정의 때문입니다.
- 논리적 귀결: 만약 Local Minimum보다 더 낮은 지점(Global Minimum)이 다른 곳에 존재한다면, 볼록성 정의에 의해 그 두 지점을 잇는 선분 아래로 함수값이 위치해야 합니다. 하지만 이는 Local Minimum 지점이 “주변에서 가장 낮다”는 전제에 모순되므로, 볼록 함수에서는 Local Minimum이 발견되는 즉시 그것이 전체 최적해(Global Optimum)임을 보장할 수 있습니다.
2. Linear Algebra Application: Matrix Decomposition 데이터 사이언스에서 행렬 분해는 데이터의 차원을 축소하거나, 숨겨진 패턴을 찾는 데 핵심적인 역할을 한다. **
2.1 Eigen Value Decomposition (EVD, 고유값 분해) 정방행렬 $A$가 벡터 $x$의 방향은 유지하되 크기만 변환시킬 때, 그 배율을 고유값, 벡터를 고유벡터라 한다.
$Ax = \lambda x \quad (x \neq 0)$
Diagonalization (대각화) $A$가 $n$개의 선형 독립인 고유벡터를 가지면 다음과 같이 분해 가능하다.$A = Q \Lambda Q^{-1}$ • $Q$: 고유벡터들을 열로 가지는 행렬 • $\Lambda$: 고유값들이 대각선에 위치한 대각행렬 ($diag(\lambda_1, \dots, \lambda_n)$)
Properties
- 거듭제곱: $A^k = Q \Lambda^k Q^{-1}$ (계산 복잡도가 $O(n^3)$에서 $O(n)$ 수준으로 감소)
- 행렬식(Determinant): $\det(A) = \prod_{i=1}^n \lambda_i$
- Trace: $\text{tr}(A) = \sum_{i=1}^n \lambda_i$
- 대칭행렬의 성질: 대칭행렬(Symmetric Matrix)은 항상 고유값 분해가 가능하며, 고유벡터들이 서로 직교(Orthogonal)한다. ($A = Q \Lambda Q^T$)
[Application] Markov Chain 상태 전이 행렬 $P$에 대해, 시간이 무한히 흐른 뒤의 안정 상태(Stationary Distribution) $\pi$는 고유값이 1일 때의 고유벡터를 찾는 문제와 같다.$\pi P = 1 \cdot \pi$
2.2 Singular Value Decomposition (SVD, 특이값 분해) EVD는 정방행렬에만 가능하지만, SVD는 모든 직사각형 행렬($m \times n$)에 적용 가능하다. $A = U \Sigma V^T$
• $U$ (Left Singular Vectors): $m \times m$ 직교행렬. ($AA^T$의 고유벡터)
• $\Sigma$ (Singular Values): $m \times n$ 대각행렬. ($\sigma_i = \sqrt{\lambda_i(A^TA)}$).
• $V$ (Right Singular Vectors): $n \times n$ 직교행렬. ($A^TA$의 고유벡터)
Geometric Interpretation (기하학적 의미) 행렬 $A$에 의한 선형 변환은 세 단계로 분해된다:
- Rotate ($V^T$): 입력 공간을 회전.
- Stretch ($\Sigma$): 축 방향으로 $\sigma_i$ 만큼 확대/축소.
- Rotate ($U$): 출력 공간으로 회전. **
2.3 Principal Component Analysis (PCA, 주성분 분석) 고차원 데이터의 분산(Variance)을 최대한 보존하면서 저차원으로 축소하는 기법.
Key Idea • 데이터의 분산이 가장 큰 방향이 가장 많은 정보(Information)를 담고 있다. • 공분산 행렬(Covariance Matrix)의 고유벡터가 곧 주성분(Principal Component, PC)의 방향이다. • 고유값의 크기가 해당 축이 설명하는 분산의 양이다.
Steps
- 데이터 중심화 (Centering, 평균 0으로 이동).
- 공분산 행렬 $C = \frac{1}{n-1} X^T X$ 계산.
- $C$를 EVD 하거나, 데이터 $X$를 바로 SVD 수행.
- 가장 큰 고유값에 해당하는 고유벡터(PC1)부터 순서대로 선택하여 사영(Projection). **
3. Summary & Cheatsheet
| Concept | Condition / Formula | Key Meaning |
|---|---|---|
| Linear Indep. | $\sum c_i v_i = 0 \Rightarrow \forall c_i=0$ | 정보의 중복 없음 (No Multicollinearity) |
| Full Rank | $\text{rank}(A) = \min(m, n)$ | 역행렬 존재, 해가 유일함 |
| PD Matrix | $x^T A x > 0$ | 볼록 최적화 가능 (Global Min 존재) |
| Orthogonal | $Q^T Q = I$ | 회전 변환 (거리, 각도 보존) |
| EVD | $A = Q \Lambda Q^{-1}$ | 정방행렬의 거듭제곱 단순화, 고유 특성 파악 |
| SVD | $A = U \Sigma V^T$ | 모든 행렬 분해 가능, PCA의 기본 원리 |
| PCA | Max Variance Direction | 차원 축소, 노이즈 제거 |
[Derivation Note] Why $det(A) = \prod \lambda_i$?
대각화 가능한 행렬 $A$에 대해 $A = Q \Lambda Q^{-1}$ 이 성립한다.
양변에 행렬식(Determinant)을 취한다.$\det(A) = \det(Q \Lambda Q^{-1})$
행렬식의 곱셈 성질 $\det(AB) = \det(A)\det(B)$을 이용한다.
$\det(A) = \det(Q) \cdot \det(\Lambda) \cdot \det(Q^{-1})$
- 역행렬의 행렬식 성질 $\det(Q^{-1}) = \frac{1}{\det(Q)}$ 을 이용한다.
$\det(A) = \det(Q) \cdot \det(\Lambda) \cdot \frac{1}{\det(Q)} = \det(\Lambda)$
대각행렬 $\Lambda$의 행렬식은 대각 원소의 곱과 같다.$\det(\Lambda) = \lambda_1 \times \lambda_2 \times \dots \times \lambda_n$
결론: $\therefore \det(A) = \prod_{i=1}^n \lambda_i$
Reference: 26-1 DSL Spring Session - Linear Algebra Basic