⚡️ Basic Statistics - 1 - [Sampling Methods]
Sampling
1.고유값 분해(EVD)와 행렬의 대각화
대각화?
→ 정방행렬 $A∈R^{n×n}$에 대하여, 가역행렬 $P$ 와 대각행렬 $D$ 를 이용해 $A=PDP^{−1}$로 표현하는 과정
- 대각화의 필요충분조건: 행렬 $A$ 가 대각화 가능하기 위해서는 반드시 서로 선형 독립인 $n$ 개의 고유벡터가 존재해야 함.
- 구조적 의미: 고유벡터 행렬 $Q$ 와 고유값 대각행렬 $Λ$ 를 이용한 $A=QΛQ^{−1}$분해는 선형 변환 $A$ 를 고유한 방향성(벡터)과 그 크기(스칼라)로 완전히 분리하여 분석할 수 있게 한다.
고유값 분해(EVD)의 한계 대칭인 정방행렬에 국한되어 적용된다
반면, 특이값 분해(SVD)는 행렬의 형태나 대칭성에 관계없이 모든 m×n 직사각 행렬에 적용 가능한 ‘데이터 과학의 맥가이버 칼(Swiss Army Knife)’입니다.
이러한 범용성 덕분에 SVD는 실제 세계의 비정형 데이터 행렬을 다루는 잠재 의미 분석(LSA)이나 추천 시스템의 행렬 분해 기법에서 핵심적인 역할을 수행합니다.
주성분 분석(PCA)의 통계적 본질
PCA는 데이터의 주성분을 찾는 과정이며, 이는 수학적으로 데이터의 공분산 행렬에 대해 EVD를 수행하는 것과 동일합니다.
- 고유벡터(Eigenvector): 주성분의 방향을 나타내며, 데이터의 변동성이 가장 큰 축을 의미합니다.
- 고유값(Eigenvalue): 해당 주성분 방향으로 투영된 데이터의 분산 크기를 나타냅니다. PCA는 고유값이 큰 순서대로 성분을 채택함으로써 데이터의 핵심 정보를 보존합니다.
2. 확률 분포 기반 샘플링 기법 (Sampling Methods)
모집단의 모든 데이터를 관측하는 것이 불가능한 환경에서, 샘플링은 모집단의 특성을 효율적으로 추정하기 위한 필수 기법입니다. 컴퓨터는 $U(0,1)$ 난수 생성을 기반으로 하며, 이를 적절히 변환하여 복잡한 타겟 분포를 따르는 표본을 생성합니다.
역변환 샘플링 (Inverse Transform Sampling)
누적분포함수(CDF)의 역함수를 이용하여 표본을 생성하는 기법입니다.
- 수학적 증명: $X$의 $CDF$를 $F$라 하고, $F$가 단조 증가 함수(Monotonic function)라는 속성을 가질 때 $Y=F(X)∼U(0,1)$임을 다음과 같이 증명할 수 있다.
- $G(y)=P(Y≤y)$라고 정의
- $P(F(X)≤y)=P(X≤F^{−1}(y))$로 변환 (CDF의 단조 증가성 활용)
- 정의에 따라, $P(X≤F^{−1}(y))=F(F^{−1}(y))=y$ 가 도출
- 따라서, $G(y)=y$이므로, $Y$는 균등분포를 따른다.
- 알고리즘 절차 (지수 분포 예시):
목표 분포 $p(x)$에서 직접 샘플링하는 것이 어려운 경우, 샘플링에 용이한 proposal 분포인 $q(x)$를 선택한다.
$q(x) : proposal$ 분포는 $uniform, normal$ 분포가 이용될 수 있는데, 기본적으로 $p(x)$와 비슷한 형태의 확률분포를 사용하면 좋다.
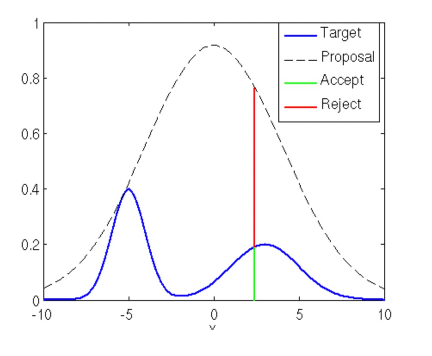
핵심 메커니즘:
모든 $x$에 대해 $p(x)≤M⋅q(x)$를 만족하는 상수 $M$을 설정합니다.
효율성 평가:
샘플의 수락 확률은 $P(accept)=1/M$ 입니다. 효율성을 극대화하려면 M을 $sup_x p(x)/q(x)$로 설정하여 기각되는 샘플을 최소화해야 합니다.
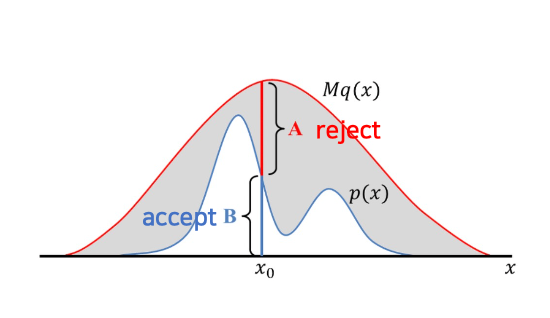
주요 개념 설명
상수 $M$의 역할 (Envelope function): ◦ 우리는 $p(x)$를 완전히 덮을 수 있는 $M \cdot q(x)$라는 함수를 만듭니다.
◦ 조건: 모든 $x$에 대해 $p(x) \le M \cdot q(x)$여야 합니다.
◦ 이때 $M$은 $p(x)/q(x)$의 비율 중 가장 큰 값(Supremum) 이상이어야 $p(x)$를 덮을 수 있으므로, 보통 최적의 효율을 위해 $M = \sup_x \frac{p(x)}{q(x)}$로 설정합니다.
수락 확률 (Probability of Acceptance): ◦ 슬라이드의 수식 $p(\text{accept}) = \frac{1}{M} \int p(x) dx$는 샘플이 기각되지 않고 뽑힐 확률을 의미합니다.
◦ 여기서 $\int p(x) dx = 1$이므로, 수락 확률은 $1/M$이 됩니다.
◦ 의미: $M$이 클수록 $1/M$은 작아집니다. 즉, $M$이 필요 이상으로 크면 샘플을 많이 버리게 되어 비효율적입니다. 따라서 $M$은 가능한 한 작을수록 좋습니다. (물론 $p(x)$를 덮는다는 조건 하에서).
📝 Rejection Sampling 예시 (Example)
문제 설정
• Target Distribution $f(y)$: $y \ge 0$인 범위에서 정의된 정규분포의 절반 형태 (Half-Normal).
$f(y) = \frac{2}{\sqrt{2\pi}} \exp(-y^2/2)$
• Proposal Distribution $h(x)$: 지수 분포 (Exponential Distribution, $\lambda=1$).
$h(x) = \exp(-x), \quad x \ge 0$ (지수 분포는 역함수 법(Inversion method)으로 쉽게 샘플 생성이 가능)
1. 최적의 상수 $M$ 찾기
Rejection Sampling의 핵심은 효율적인 $M$을 찾는 것입니다.
$M = \sup_x \frac{f(x)}{h(x)}$
비율 함수 $g(y) = \frac{f(y)}{h(y)}$를 계산하면:
$g(y) = \frac{\frac{2}{\sqrt{2\pi}} e^{-y^2/2}}{e^{-y}} = \sqrt{\frac{2}{\pi}} e^{y - y^2/2}$
이 식을 최대화하기 위해 지수 부분($y - y^2/2$)을 미분하여 0이 되는 지점을 찾습니다.
$\frac{d}{dy}(y - \frac{y^2}{2}) = 1 - y = 0 \Rightarrow y = 1$
즉, $y=1$일 때 비율이 최대가 됩니다.
$y=1$을 대입하면 최댓값 $M$이 나옵니다.
$M = \sqrt{\frac{2}{\pi}} e^{1 - 1/2} = \sqrt{\frac{2e}{\pi}}$
2. 기각 비율 (Rejection Ratio) 계산
샘플을 수락할지 말지 결정하는 기준이 되는 비율입니다.
$\frac{f(y)}{M \cdot h(y)} = \frac{1}{M} \cdot \frac{f(y)}{h(y)}$
위에서 구한 $M$과 $f(y)/h(y)$ 식을 대입하여 정리하면:
$= \frac{1}{\sqrt{2e/\pi}} \cdot \left( \sqrt{\frac{2}{\pi}} e^{y - y^2/2} \right) = e^{-0.5} \cdot e^{y - y^2/2} = \exp\left( -\frac{(y-1)^2}{2} \right)$
3. 알고리즘 실행
실제로 샘플을 생성합니다.
Generate $x$: 제안 분포인 지수 분포에서 $x$를 하나 뽑습니다. (보통 $-\ln(U)$ 등을 이용)
Generate $u_1$: 균등 분포 $U(0,1)$에서 난수 $u_1$을 뽑습니다.
판별 (Rejection Step): ◦ 만약 $u_1 \le \exp(-(x-1)^2/2)$ 이면, 이 $x$를 우리가 원하는 분포 $f(y)$의 샘플로 수락(Accept)합니다 ($y=x$). ◦ 그렇지 않으면, 이 $x$는 기각(Reject)하고 다시 1번 단계로 돌아갑니다.
🐐 Monte Carlo Approximation
1. 문제 상황: 적분의 어려움 우리가 어떤 확률변수 $x$에 대한 함수 $f(x)$의 기댓값(Expectation)을 구하고 싶을 때, 이론적인 정의는 다음과 같습니다.
$\mathbb{E}_{x \sim p}[f(x)] = \int f(x)p(x)dx$
• 의미: $x$가 나올 확률(밀도)인 $p(x)$를 가중치로 하여 $f(x)$를 모두 더한다(적분한다).
• 현실적인 문제: ◦ 수리통계학 교과서에 나오는 예제들과 달리, 실제 데이터 분석에서는 $p(x)$가 매우 복잡하거나, $x$의 차원이 매우 높아서(High-dimensional), 이 적분을 해석적으로(Analytically) 푸는 것이 불가능한 경우가 대부분입니다.
2. 해결책: 몬테카를로 근사
적분을 직접 계산할 수 없으니, “컴퓨터로 시뮬레이션(샘플링)해서 평균을 내자”
$\mathbb{E}{x \sim p}[f(x)] \simeq \frac{1}{N} \sum{n=1}^{N} f(x^{(n)})$
• 작동 원리: 1. 확률분포 $p(x)$를 따르는 표본(sample) $x^{(1)}, x^{(2)}, …, x^{(N)}$을 $N$개 뽑습니다. (여기서 앞서 배운 Rejection Sampling 같은 기법이 사용될 수 있습니다.) 2. 뽑힌 각 표본들을 함수 $f$에 대입하여 $f(x^{(n)})$ 값을 구합니다. 3. 이 값들의 산술 평균(Sample Mean)을 구합니다.
3. 이론적 근거: 큰 수의 법칙 (LLN)
“큰 수의 법칙(Law of Large Numbers)”이 이 근사법을 뒷받침하는 핵심 이론입니다.(요기서는 따로 증명하지 않을 예정)
• 샘플의 개수 $N$이 무한대로 커지면($N \to \infty$),
표본 평균(Sample Mean)은 모평균(Population Mean, 즉 우리가 구하고자 하는 기댓값)으로 확률적으로 수렴합니다.
• 따라서 $N$을 충분히 크게 잡으면, 복잡한 적분 계산 없이도 단순한 덧셈과 나눗셈만으로 기댓값을 매우 정확하게 추정할 수 있습니다.
4. 요약 및 직관적 예시
직관적 예시: “대한민국 20대 남성의 평균 키”($\mathbb{E}[f(x)]$)를 알고 싶다고 가정해 봅시다.
적분 접근: 대한민국 20대 남성 전체의 키 분포 함수를 정확히 알아내서 수학적으로 적분합니다. → (거의 불가능)
몬테카를로 접근: 길 가는 20대 남성 1,000명을 무작위로 뽑아서($x \sim p(x)$), 그들의 키를 재고($f(x)$), 그 1,000명의 평균을 냅니다. ($\frac{1}{N}\sum$)
중요도 샘플링 (Importance Sampling)
몬테 카를로에서 적분하기 힘드니까 $p(x)$에서 샘플링 후 산술 평균을 구했다면, 중요도 샘플링에서는 그 샘플링 조차 힘들 때 사용
1. 기본 아이디어
우리가 알고 싶은 건 분포 $p(x)$ 하에서의 기댓값입니다. 하지만 $p(x)$에서 샘플을 못 뽑으니, 샘플링하기 쉬운 만만한 분포 $q(x) (Proposal)$를 대신 가져와서 뽑습니다.
2. Weighting
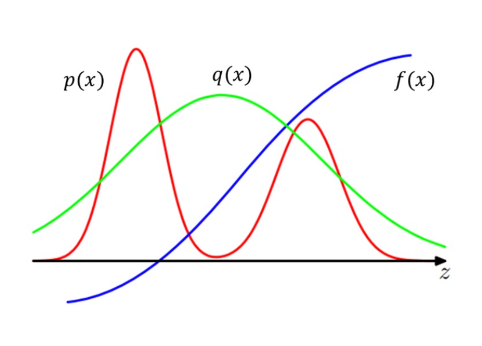
수식의 변형 과정이 핵심입니다. 적분 식에 $\frac{q(x)}{q(x)}$를 곱해줍니다. (물론 $q(x) \neq 0$)
$\mathbb{E}_{x \sim p}[f(x)] = \int f(x) \cdot p(x) dx = \int f(x) \frac{p(x)}{q(x)} \cdot q(x) dx$
이 식을 다시 해석하면 다음과 같습니다.
$= \mathbb{E}_{x \sim q} \left[ f(x) \frac{p(x)}{q(x)} \right]$
즉, “$q(x)$에서 샘플링을 하되, $p(x)$와 $q(x)$의 확률 비율(가중치)만큼 보정해준다”는 뜻입니다.
• Importance Weight (중요도 가중치): $w(x) = \frac{p(x)}{q(x)}$
• 직관적 해석:
• $p(x)$에서는 자주 나올 값인데 $q(x)$에서는 드물게 나온다면? $\rightarrow$ 가중치($w$)를 높여서 보상해줍니다. • $p(x)$에서는 드문데 $q(x)$에서 자주 나온다면? $\rightarrow$ 가중치($w$)를 낮춰서 영향력을 줄입니다.
3. 분산 분석과 $q(x)$의 선택
Importance Sampling은 이론적으로는 비편향 추정량(Unbiased Estimator)입니다. 즉, 샘플이 무한히 많으면 참값으로 수렴합니다. 하지만 샘플이 유한할 때의 ‘분산(Variance)’이 문제입니다. **
(1) 분산 식의 의미 슬라이드의 빨간 박스 부분을 보십시오. Importance Sampling을 적용했을 때의 분산에는 다음 항이 포함됩니다.
$\mathbb{E}_{x \sim p} \left[ \frac{p(x)}{q(x)} (f(x))^2 \right]$ 여기서 비율 $\frac{p(x)}{q(x)}$가 핵심 트리거입니다.
(2) 위험성 (High Variance) 만약 $p(x)$는 큰데 $q(x)$가 매우 작은 구간이 존재한다면? • $\frac{p(x)}{q(x)}$값이 폭발적으로 커집니다. • 이로 인해 추정량의 분산(Variance)이 매우 커지게 됩니다. • 즉, 시뮬레이션을 돌릴 때마다 결과값이 들쑥날쑥해서 믿을 수 없게 됩니다. **
(3) 결론: 좋은 $q(x)$란? • “Choice of q(x) is very important!!” • $p(x) \times |f(x)|$가 큰 곳에서는 $q(x)$도 커야 합니다. • 일반적으로 $q(x)$의 꼬리(Tail)가 $p(x)$보다 두꺼워야(Heavier) 분산 폭발을 막을 수 있습니다. $q(x)$가 $p(x)$를 충분히 커버하지 못하면 추정은 실패할 확률이 높습니다. **
REFERENCE: 26-1 Data Science Lab Basic Statistics Session
Google Gemini
Googel NotebookLM