강화학습 Reinforcement Learning
Deep Reinforcement Learning
1. Foundation of Reinforcment Learning
정적인 데이터셋 $(X,Y)$ 를 학습하여 예측하는 지도 학습과는 다르게, 모델(Agent)가 동적인 환경과 상호작용하여 학습하는 방식
목표: 에이전트가 활동 공간에서 행동을 취하고, 그 결과로 보상을 받는다. 미래의 보상 총합을 최대화하는 것이 궁극적인 목표.
데이터와 라벨(이상적인 목표치) 대신 action-state pairs를 데이터로 사용한다.
- 에이전트가 행동($a_i$)을 취함
- 환경은 행동에 대한 반응으로 새로운 관측($s_{t+1}$)과 보상($r_t$)을 반환
- 종료시점 $T$까지 반복하여 누적 보상을 최대화하는 방향으로 학습한다.
- Return / Q-function
- 총 보상 (total return, $R_t$):특정 시점 $t$부터 미래에 얻게될 모든 보상의 합이다.($\sum r_i$)
- 할인률(Discount Factor, $\gamma$) : 미래의 보상은 현재의 가치보다 가치가 낮을 수 있다. 미래의 보상에 할인률을 적용. —> Discounted Future Total Reward
- Q-function($Q(s,a)$): 특정상태($s$)에서 특정행동($a$)를 했을 때 기대할 수 있는 미래의 총 보상(Extpected Total Future Reward)를 나타내는 함수
—> 에이전트는 Q-함수를 사용하여, 가능한 모든 행동 중 가장 높은 기대 보상을 주는 행동($\text{argmax} Q(s,a)$)를 선택하여 최적의 결정을 내릴 수 있다.
2. 학습 방법론
—> Value Learning / Policy Learning
Value Learning : Q-함수와 Deep Q-Networks (DQN)
Q-함수는 특정 상태(s)에서 행동(a)을 취했을 때 기대되는 미래 누적 보상의 기댓값을 산출합니다.
\[Q(s_t, a_t) = E[R_t \mid s_t, a_t]\]에이전트의 최적 정책 $\pi^*(s)$은 모든 가능한 행동 중 Q-값을 최대화하는 행동을 선택하는 것입니다.
\[\pi^*(s) = \underset{a}{\text{argmax}} \, Q(s,a)\]Deep Q-Network
Atari ‘Breakout’
상태공간/행동공간
-상태공간 : 에이전트가 관찰할 수 있는 현재 모든 상황의 집합
—> ex : Atari ‘Breakout’ 에서는 남은 블럭의 개수, 패들의 위치, 등등
-행동공간 : 에이전트가 취할 수 있는 모든 행동의 집합
—> ex : Atari ‘Breakout’ 에서는 상하좌우 방향키(이산적 행동공간)
조이스틱을 30도 각도로 10만큼의 힘을 준다(연속적 행동공간)
학습 원리 (Bellman Equation): DQN은 벨만 방정식(Bellman Equation)에 기초하여 학습한다. 네트워크가 예측한 현재의 Q-값(Predicted)과 실제 보상 및 다음 상태의 최대 Q-값을 합친 목표값 $(Target, r+\gamma \max_{a’} Q(s’,a’))$사이의 오차인 Q-Loss를 줄이는 것이 핵심
\[Loss = || (r + \gamma \max_{a'} Q(s', a')) - Q(s,a) ||^2\]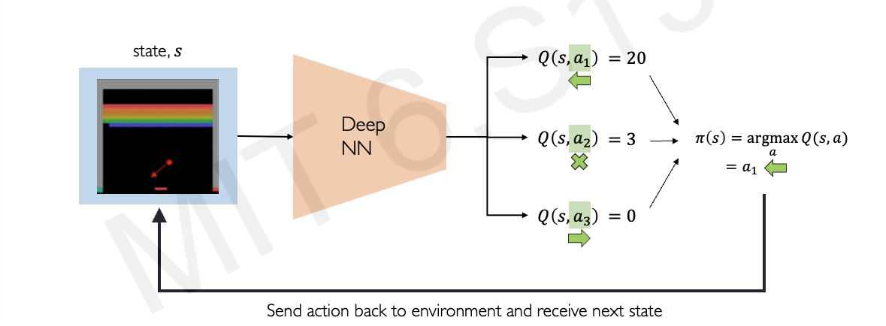
한계 : 이산적 행동 공간에 국한되고, 자율 주행에서는 연속적 환경을 다루기 때문에, Policy gradient 기법이 사용된다.
—> 같은 input 값을 주면 횟수와 상관없이 항상 같은 결과값이 도출된다. 즉, stochastic policies 학습 불가능
Policy Learning
연속적(Continuous) 행동 공간에서는 무한한 선택지가 존재하므로 DQN의 argmax 방식은 적용이 불가능. PG는 행동의 확률 분포(예: 가우시안 분포의 평균$\mu$와 분산$\sigma^2$)를 모델링하여 정교한 제어를 가능하게 함
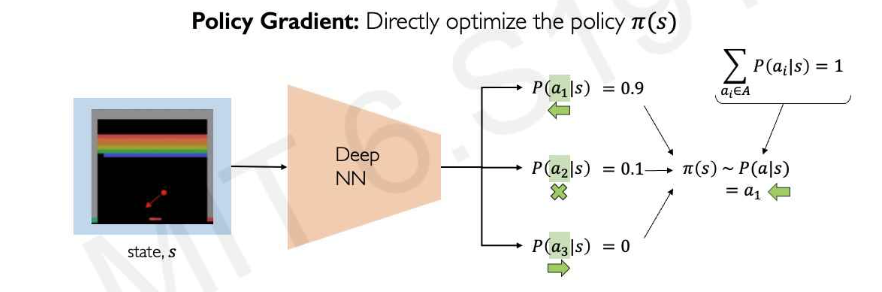
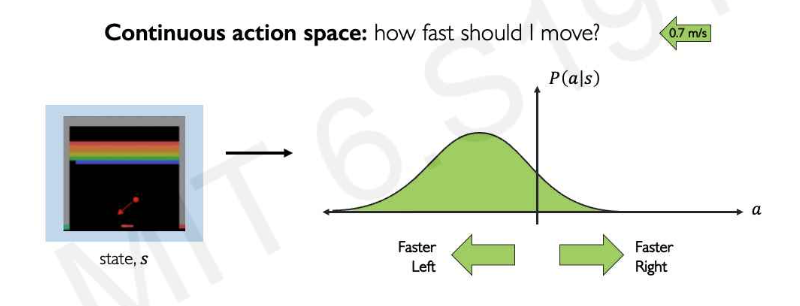
PG(policy gradient)의 손실 함수
\[Loss = - \log P(a_t \mid s_t) R_t\]마이너스 부호가 붙는 이유는 딥러닝 최적화의 특성 때문. 누적 보상($R_t$)을 최대화(Maximize)하고자 하지만, 표준적인 경사 하강법(Gradient Descent)은 손실을 최소화(Minimize)하는 방향으로 작동한다.
따라서 로그 확률 앞에 마이너스를 붙여 보상이 클수록 손실이 줄어들게 설계함으로써, 결과적으로 보상을 극대화하는 방향으로 네트워크를 업데이트하게 될 것이다.
학습 단계
- 에이전트 활성화
- 종료시점까지 작동시킴
- 모든 state, action, reward를 기록
- reward가 낮은 action들은 확률을 낮춘다.
- reward가 큰 action들은 확률을 높인다.
4,5 —> Back Propagation
말풍선 안보이면 다크모드로…
실세계에서 문제가 되는 단계
종료시점까지 작동시킴
출처. Jaden williams LIVE YouTube
—> 실제 사람이 탄 차를 사고를 내면서 학습시킬 수는 없음(인간의 목숨은 하나기 때문에..!)
VISTA는 데이터 기반의 Photorealistic(사진과 같은 실사구시적) 및 High-fidelity 시뮬레이터
전략적 임팩트: 시뮬레이션 내에서 무한한 시행착오를 겪으며 Policy Gradient로 훈련된 에이전트는, 별도의 수정 없이 실제 차량에 탑재되어 안정적인 주행을 보여줬다. 이는 가상 세계의 학습이 실세계(Real-world)로 전이될 수 있음을 입증한 사례
하이브리드 학습(AlphaGo)
AlphaGo는 지도학습과 강화학습을 결합한 2단계 전략으로 인간의 지능을 넘어섰다.
- 초기 학습 (Supervised Learning): 인간 전문가의 기보를 바탕으로 특정 수에 대한 Classification(분류) 학습을 수행하여 기초 정책을 형성했다.
- 자기 대국 (Self-play RL): 이후 강화학습을 통해 스스로와 대국하며 데이터를 생성하고, 가치 네트워크를 통해 국면의 승률을 예측하는 Regression(회귀) 학습을 병행하여 초인적 성능에 도달했다.
출처 : MIT 6.S191: Reinforcement Learning Google Gemini, NotebookLM